Por que a nossa voz gravada parece estranha

Quase todo mundo já passou por isso: você abre uma mensagem de voz que enviou no WhatsApp, assiste a um vídeo seu ou ouve a gravação de uma apresentação e pensa, com um leve constrangimento, “essa não pode ser a minha voz”. Ela parece mais fina, mais nasal, menos imponente do que aquela que você escuta todos os dias dentro da própria cabeça. A reação é tão comum que virou piada em podcasts, aulas de oratória e rodas de amigos.
O estranhamento, porém, não é fruto de vaidade nem de má qualidade do celular. Ele nasce de uma combinação de física, anatomia e psicologia: ouvimos a nós mesmos por um caminho diferente do que todas as outras pessoas usam, e o cérebro construiu, ao longo de uma vida inteira, uma expectativa muito específica sobre como “nossa voz” deveria soar. Neste texto, reunimos o que a literatura científica diz sobre cada uma dessas peças e por que a gravação, embora seja a versão mais fiel do som que chega ao mundo, quase sempre soa errada para quem a produziu.
Roteiro de leitura: os caminhos do som até o ouvido; o que as pesquisas mediram; o papel do cérebro e das expectativas; e o que fazer com tudo isso.
Dois caminhos para o mesmo som
Quando alguém fala com você, o som chega por um único caminho: o ar leva as vibrações até o canal auditivo, o tímpano vibra e a cóclea faz o resto. Esse é o caso da condução aérea. Mas, quando é você quem fala, existe um segundo caminho. As pregas vocais vibram, e essa vibração se propaga pelos tecidos moles, pelo crânio e pela mandíbula até a própria orelha interna, a condução óssea (ou tecidual). O físico húngaro Georg von Békésy descreveu esses dois componentes já em 1949, em estudos sobre como ouvimos a própria voz [1].
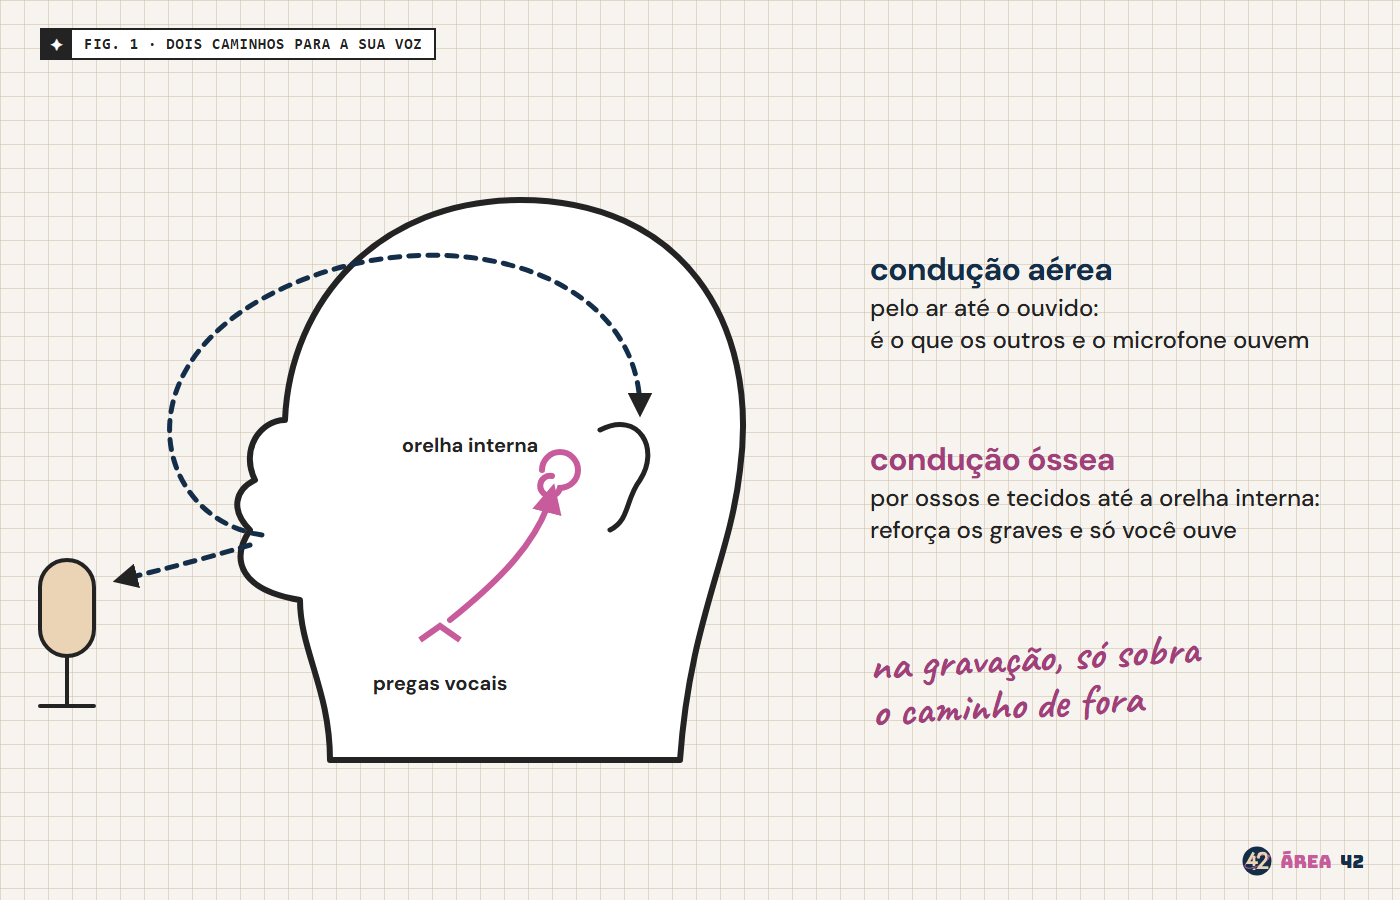
O resultado é uma mistura. Como a condução pelos ossos e tecidos favorece as frequências graves, a voz que você ouve falando é mais “cheia”, mais profunda e mais encorpada do que a que sai de sua boca. Uma pesquisa clássica de Pörschmann [2] sugere que, na faixa de cerca de 700 a 1200 Hz, a condução óssea domina a percepção da própria voz. Já a revisão de Stenfelt e Goode [3] reúne as bases fisiológicas desse fenômeno, que é também a razão de a audiometria clínica usar vibradores ósseos para testar a cóclea.
Uma analogia ajuda: é como ouvir uma música de dentro de uma sala com o som dos alto-falantes e o grave sendo sentido pelo chão, e depois ouvir a gravação dessa mesma música em um fone barato. A informação está toda lá, menos a parte que você sentia vibrar.
É por isso que a gravação não carrega esse componente. O microfone captura apenas o som aéreo, aquele que atinge as outras pessoas. Quando você aperta o play, sua orelha recebe a voz exatamente como o seu interlocutor a recebe, só que, pela primeira vez, sem a “trilha de graves” interna que a acompanha quando você fala. Kimura e Yotsumoto resumem o ponto assim: a voz que se ouve ao falar inclui condução óssea e aérea, ao passo que a voz gravada inclui apenas a aérea [5].
A contribuição da condução óssea também foi demonstrada de forma experimental e inversa. Em 2023, Orepić e colegas, do Laboratório de Neurociência Cognitiva da EPFL, na Suíça, fizeram voluntários ouvirem versões de suas vozes misturadas com as de outras pessoas, ora por fones comuns (condução aérea), ora por fones de condução óssea. Os participantes distinguiram melhor a própria voz quando ouvida por condução óssea, efeito que não apareceu na discriminação entre vozes de pessoas conhecidas e desconhecidas [4]. Em outras palavras, o canal ósseo é parte do que faz a voz soar como “minha”.
O que os experimentos mostram (e o que complica a explicação simples)
A explicação “é a condução óssea” é correta, mas incompleta. Quando os pesquisadores tentaram simplesmente aplicar um filtro de graves à gravação para reproduzir como a pessoa se ouve, a coisa se mostrou mais complicada do que parecia.
Em 2018, Kimura e Yotsumoto, da Universidade de Tóquio, compararam diferentes filtros de equalização (do tipo “passa-baixas”, “passa-banda” e outros) que a literatura tinha proposto para fazer a gravação soar como a voz “de dentro”. Eles encontraram grandes diferenças individuais na escolha do filtro mais representativo, e concluíram que não existe um filtro geral capaz de representar a voz própria para todo mundo [5]. Em termos práticos: o “graveamento” que você precisaria aplicar à sua gravação para soar familiar a si mesmo é diferente do que outra pessoa precisaria, porque a anatomia do crânio, dos tecidos e do trato vocal varia de indivíduo para indivíduo.
A hipótese de que a gravação soa “mais aguda” porque falta o grave também foi posta à prova. Em um estudo apresentado na revista Canadian Acoustics por pesquisadores da Universidade da Colúmbia Britânica (Walter e colegas), 46 participantes foram gravados dizendo uma frase neutra e depois ouviram a própria gravação sem alteração. Cerca de 87% deles, tanto mulheres quanto homens, acharam que a gravação havia sido adulterada, embora ninguém tivesse mexido nela. E, entre os que sentiram que a voz fora alterada, a maioria disse que ela havia sido abaixada, e não elevada, contrariando a previsão de uma hipótese estritamente baseada em condução óssea [6]. Trata-se de um estudo pequeno e de um resumo de congresso, e portanto deve ser lido com cautela; mas ele sugere que o cérebro não é um receptor passivo. O sistema perceptivo parece compensar o que “sabe” que falta, e essa compensação pode até exagerar na direção contrária, de modo que o desacordo é mais do que um simples problema de filtro.
Outra pista vem do próprio experimento de Orepić e colegas [4]: mesmo com condução óssea, as vozes do próprio participante foram mais confundidas com vozes familiares do que com vozes desconhecidas, independentemente da semelhança acústica. Ou seja, a identificação da própria voz depende de sinal acústico, de vibração e de uma espécie de memória de familiaridade, tudo ao mesmo tempo. Os autores descrevem a voz própria como um “construto multimodal”, que não se reduz ao som que chega ao ouvido [4].
Por fim, vale desfazer um mito comum. Kimura e Yotsumoto também investigaram se a gravação soaria “fantasmagórica” no sentido do vale da estranheza, aquela sensação perturbadora de algo quase humano, mas não totalmente. Concluíram que o vale da estranheza não existe especificamente para a voz própria [5]. O incômodo, portanto, parece menos um “susto” e mais uma incongruência entre uma expectativa muito sólida e o som que de fato chega.
O cérebro também “sabe” o que vai ouvir
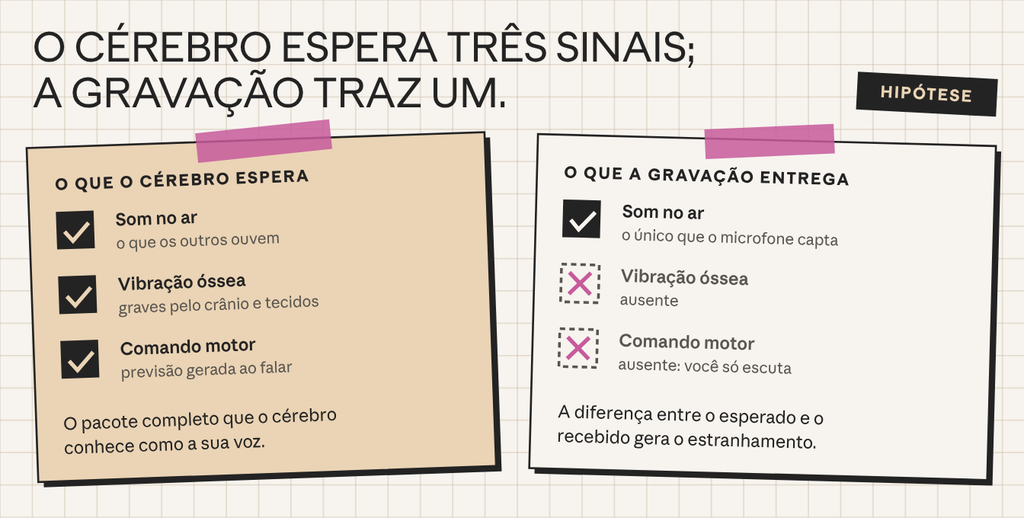
Há uma segunda peça nessa história, e ela está dentro da cabeça. Quando você fala, o cérebro não espera passivamente o som chegar: ele envia aos centros auditivos uma cópia do comando motor (a chamada cópia de eferência) e, com base nela, prevê como a própria voz vai soar. Estudos de magnetoencefalografia mostram que a resposta do córtex auditivo à fala produzida pela própria pessoa é menor do que a resposta à reprodução gravada da mesma fala, um fenômeno conhecido como supressão induzida pela fala [7]. Em um experimento de Heinks-Maldonado e colegas, a resposta foi mais reduzida quando o retorno auditivo era a voz do participante sem alteração, e menos reduzida quando a voz vinha deslocada em frequência ou era a de outra pessoa, o que sugere que o retorno auditivo é comparado com uma previsão interna [8].
Essa literatura trata da fisiologia da fala, e não da estranheza da gravação em si, de modo que a ponte entre as duas coisas é uma hipótese razoável, não uma conclusão estabelecida. Ainda assim, ela faz sentido: depois de décadas de prática, seu cérebro tem um “modelo” detalhado do que “minha voz” deveria soar, composto de som aéreo, vibração óssea e a sensação motora de articular cada palavra. A gravação entrega só uma parte desse pacote. Falta a vibração e falta a sensação de comando motor, que simplesmente não existe quando você apenas escuta. O resultado é uma discrepância entre previsão e realidade, e o cérebro costuma interpretar discrepâncias como erro, ou como “isso não é meu”.
Um estudo de neuroimagem de Hosaka, Kimura e Yotsumoto aponta na mesma direção. Quando os participantes ouviam versões de sua voz mais ou menos semelhantes à que percebiam como própria, o giro temporal superior (uma região auditiva) ficava mais ativo diante da voz menos parecida com a deles e menos ativo diante da mais parecida [9]. Isso é compatível com a ideia de que sons próximos da representação interna da própria voz demandam menos do córtex auditivo.
Um exemplo cotidiano ilustra a ideia: na primeira vez que você escuta uma mensagem de voz sua, o seu “modelo” de si mesmo é confrontado, sem aviso, com a versão que as outras pessoas sempre ouviram. Para elas, a gravação é só mais uma amostra de uma voz que já conhecem; para você, é a primeira vez que o som chega sem o resto do pacote.
Estranhar não é o mesmo que achar feia
É tentador concluir que odiamos a gravação porque nossa voz é objetivamente pior do que imaginamos. A psicologia experimental diz o contrário. Em 2013, Hughes e Harrison pediram a 80 voluntários que avaliassem a atratividade de várias gravações de pessoas contando de um a dez, sem avisar que as próprias vozes dos participantes estavam no conjunto. Os voluntários avaliaram a própria voz como mais atraente do que outras pessoas a avaliaram, e também como mais atraente do que as vozes dos outros. Os autores interpretaram o resultado como uma forma de “egotismo vocal implícito”, ou seja, uma autovalorização inconsciente [10]. Peng e colaboradores mostraram, em 2019, que esse viés de valorização se estende a versões semelhantes e familiares da própria voz, como a gravação, em comparação com versões alteradas em altura [11].
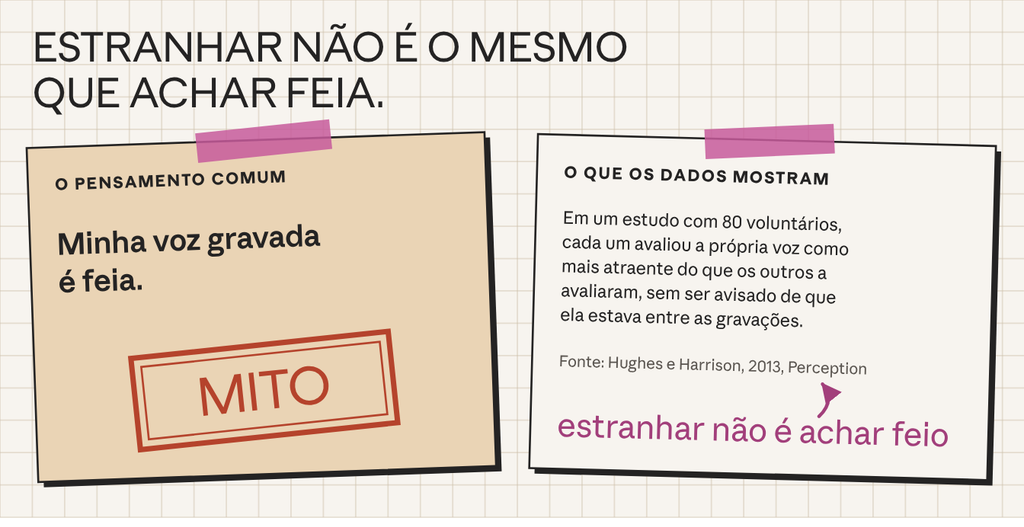
ilustração · o mito da voz gravada feia × o resultado de Hughes e Harrison (2013)
Como conciliar isso com o desconforto relatado desde os anos 1960, quando Holzman e Rousey já descreviam a insatisfação com a voz percebida como “própria” [12]? A diferença está em saber que é você. Quando a voz aparece de forma anônima, no meio de outras, o efeito de familiaridade e a tendência a gostar do que é nosso tendem a favorecê-la. Quando você sabe que é a sua gravação, ela é imediatamente comparada com aquela expectativa interna construída por condução óssea, controle motor e décadas de repetição, e a diferença incomoda. O estranhamento, portanto, mede a distância entre a voz esperada e a voz recebida, e não a qualidade da voz.
O mesmo mecanismo ajuda a entender fenômenos cotidianos:
- A mensagem de voz no WhatsApp. Você ouve a gravação antes de enviar, estranha o timbre e regrava duas vezes. A voz que seu amigo recebe é a mesma de todas as conversas pessoais que vocês já tiveram, porque ele nunca ouviu a versão “com graves internos”.
- O podcast ou a aula gravada. Quem começa a gravar conteúdo costuma passar por um período de desconforto que diminui com a exposição. É o efeito de familiaridade agindo: quanto mais você escuta a versão externa, mais ela se aproxima do seu modelo interno.
- A chamada de vídeo. A tela mostra uma imagem espelhada e um som sem vibração óssea. É uma dupla discrepância, e é comum a pessoa se incomodar com a própria imagem e com a própria voz ao mesmo tempo.
A flexibilidade desse “modelo” também aparece em um experimento curioso, o da “ilusão da voz de borracha”: quando uma voz de estranho é tocada em sincronia com a fala do participante, funcionando como retorno auditivo de sua própria fala, ele pode percebê-la como uma versão modificada da sua própria voz [13]. A identidade vocal, portanto, depende do som, mas também da coincidência com o movimento e a intenção de falar. Isso reforça a ideia central deste texto: a “minha voz” é uma construção do cérebro, e não só um sinal acústico.
O que fazer com o estranhamento
Não existe, até onde a literatura consultada mostra, uma intervenção comprovada para “curar” a estranheza da própria gravação. O que a pesquisa permite é tirar algumas conclusões práticas, que devem ser lidas como inferências e não como resultados testados.
A primeira é que a gravação é a versão fiel do que os outros ouvem. Se a sua voz parece fina ou nasal ali, é porque, para quem escuta, ela é exatamente isso, e não necessariamente desagradável: os dados de Hughes e Harrison sugerem que, às cegas, tendemos a avaliar a própria voz de forma até favorável [10]. A segunda é que não adianta tentar “consertar” a gravação com um equalizador: Kimura e Yotsumoto não encontraram um filtro que reproduza a voz interna de todo mundo, porque ele varia de pessoa para pessoa [5]. A terceira é a exposição: como a familiaridade parece contribuir para a preferência pelo que é nosso [10][11], faz sentido esperar que ouvir a própria gravação com regularidade, como fazem apresentadores, professores e quem grava podcasts, aproxime o modelo interno da versão externa.
Moral da história (cientificamente falando)
A nossa voz gravada parece estranha porque ouvimos a nós mesmos de um jeito que ninguém mais ouve. Quando falamos, o som chega ao ouvido por dois caminhos, o aéreo e o ósseo [1][2][3]; a gravação preserva apenas o primeiro. Por cima dessa diferença física, o cérebro compara o que escuta com uma previsão construída pelo comando motor e por décadas de hábito [7][8], e estranha a discrepância. Os estudos mais recentes mostram, porém, que a explicação não se resume à condução óssea: há diferenças individuais grandes, há compensações perceptivas que levam as pessoas a achar que a gravação foi “abaixada” mesmo sem alteração [5][6], e há um viés de autovalorização que faz com que, sem saber que é a nossa, tendamos a gostar dela [10].
A próxima vez que você se ouvir, vale lembrar: não é a voz que está errada. O que se estranha é o reencontro com a versão do seu som que todo mundo conhece, e que você, por uma peculiaridade da anatomia e da cognição, quase nunca escuta sozinho.
Referências
- von Békésy, G. (1949). The structure of the middle ear and the hearing of one’s own voice by bone conduction. Journal of the Acoustical Society of America, 21(3), 217–232.
- Pörschmann, C. (2000). Influences of bone conduction and air conduction on the sound of one’s own voice. Acta Acustica united with Acustica, 86(6), 1038–1045.
- Stenfelt, S., & Goode, R. L. (2005). Bone-conducted sound: physiological and clinical aspects. Otology & Neurotology, 26(6), 1245–1261.
- Orepić, P., Kannape, O. A., Faivre, N., & Blanke, O. (2023). Bone conduction facilitates self-other voice discrimination. Royal Society Open Science, 10(2), 221561. https://pmc.ncbi.nlm.nih.gov/articles/PMC9929504
- Kimura, M., & Yotsumoto, Y. (2018). Auditory traits of “own voice”. PLoS ONE, 13(6), e0199443. https://pmc.ncbi.nlm.nih.gov/articles/PMC6019673
- Walter, M., Norris, S., Bengtson, G., Fong, L. K., & Gick, B. Own-voice pitch perception isn’t just about bone conduction. Canadian Acoustics (Universidade da Colúmbia Britânica). https://jcaa.caa-aca.ca/index.php/jcaa/article/download/4249/3706/7853
- Houde, J. F., Nagarajan, S. S., Sekihara, K., & Merzenich, M. M. (2002). Modulation of the auditory cortex during speech: an MEG study. Journal of Cognitive Neuroscience, 14(8), 1125–1138.
- Heinks-Maldonado, T. H., Nagarajan, S. S., & Houde, J. F. (2006). Magnetoencephalographic evidence for a precise forward model in speech production. NeuroReport, 17(13), 1375–1379. https://pmc.ncbi.nlm.nih.gov/articles/PMC4060597
- Hosaka, T., Kimura, M., & Yotsumoto, Y. (2021). Neural representations of own-voice in the human auditory cortex. Scientific Reports, 11, 591. https://pmc.ncbi.nlm.nih.gov/articles/PMC7804419
- Hughes, S. M., & Harrison, M. A. (2013). I like my voice better: self-enhancement bias in perceptions of voice attractiveness. Perception, 42(9), 941–949. https://journals.sagepub.com/doi/10.1068/p7526
- Peng, Z., Wang, Y., Meng, L., Liu, H., & Hu, Z. (2019). One’s own and similar voices are more attractive than other voices. Australian Journal of Psychology, 71(3), 212–222. https://doi.org/10.1111/ajpy.12235
- Holzman, P. S., & Rousey, C. (1966). The voice as a percept. Journal of Personality and Social Psychology, 4(1), 79–86.
- Zheng, Z. Z., MacDonald, E. N., Munhall, K. G., & Johnsrude, I. S. (2011). Perceiving a stranger’s voice as being one’s own: a “rubber voice” illusion? PLoS ONE, 6(4), e18655. https://pmc.ncbi.nlm.nih.gov/articles/PMC3072407
Fontes complementares consultadas (divulgação, não usadas como base de afirmações científicas): EPFL – Orepić e a percepção da própria voz; PsyPost – bone-conduction tech and voice perception; ScienceDaily – estudo de Hughes e Harrison.